Kaggle-Zillow EDA
Kaggle - EDA(Zillow-practice)
Can you improve the algorithm that changed the world of real estate?
두번째 EDA 실습, 공부로 부족했던 제 첫 EDA에 대한 리뷰를 겸해 Zillow Prize에 대한 필사를 해보겠습니다. 저번 실습에서 많은 부분에 부족함을 느꼈기 때문에 이번 리뷰를 철저히 하기 위해서 Zillow Prize에 대회 설명부터 하나씩 차근차근 진행하겠습니다.
“Zestimates” are estimated home values based on 7.5 million statistical and machine learning models that analyze hundreds of data points on each property. And, by continually improving the median margin of error (from 14% at the onset to 5% today), Zillow has since become established as one of the largest, most trusted marketplaces for real estate information in the U.S. and a leading example of impactful machine learning.
“Zestimates” (Zillow에서 제공하는 부동산정보) 약 750만개의 통계와 각 재산에 대한 수백개의 데이터 포인트들을 분석한 머신러닝 모델을 토대로 부동산의 가치를 매깁니다. 오차의 중위수(median)를 14%에서 5%까지 계속 증가시키면서 Zillow는 부동산 정보를 제공하는 가장 크고 믿음직한 시장 중 하나로 자리매김 했고, 또한 머신러닝의 영향력을 보여주는 좋은 예시가 되고 있습니다.
머신러닝에 대한 세미나나 이런 저런 강의를 듣다보면 부동산 가격 예측을 포함해서 부동산에 관한 얘기를 정말 많이 들을 수 있었는데 Zillow 문제는 그 대표적인 예시입니다. 부동산 시장은 큰 만큼 큰 돈이 움직이는 시장이다 보니 데이터에 대해서 사람들이 더 확신을 얻고 싶어하고 그 방법으로 머신러닝, 데이터과학을 이용한 점이 당연하게 느껴지면서도 머신러닝의 영향력이 어느수준인가에 대해 알 수 있습니다.
이번 리뷰에서는 직접 EDA는 진행하지 않고, 많은 vote를 받은 “SRK” 라는 유저의 노트북을 보고 EDA 필사에 초점을 두겠습니다.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
color = sns.color_palette()

%matplotlib inline

pd.options.mode.chained_assignment = None
pd.options.display.max_columns = 999
우선 모듈들을 import하는 코드입니다.
- 기본적으로 numpy, pandas, matplotlib, seaborn을 사용한다는 점을 알 수 있었고,
color = sns.color_palette()를 통해 사용할 색상을 미리 정해놓는다는 점을 알 수 있었습니다.- IPython에서 제공하는 Rich output를 표현하기 위해
%matplotlib을 사용했습니다. pd.options.mode.chained_assignment = None을 통해 추후에 생길수도 있는 chained indexing 이슈에 대해 경고문구를 아얘 띄우지않게 처리했습니다. 지난 EDA 과제를 할 때 문제를 겪었던 부분이기도 해 https://stackoverflow.com/questions/20625582/how-to-deal-with-settingwithcopywarning-in-pandas 를 참고해 따로 정리해봐야겠습니다.
from subprocess import check_output
print(check_output["ls", "../input"]).decode("utf-8")
항상 간과하고 넘어가거나 직접 폴더안에 어떤 파일이 있는 지를 살펴보기만 하고 명시해주지 않았는데, 이런식으로 명시를 해줘야겠습니다.
- 파이썬의 모듈
subprocess의check_output을 사용했습니다."ls"방법을 이용해".../input"을 출력했습니다. 사실subprocess는 현재 소스코드안에서 다른 프로세스 실행을 가능하게 해주고, 그 과정에서 입출력을 제어하기 위함으로 결과값을 다른 변수에 저장할 수 있다는 장점이 있습니다. 여기서는 단순히 출력을 편리하게 하기 위해 사용한 것 같지만, 나중에 관련해서 더 찾아봐야겠습니다.
train_df = pd.read_csv("../input/train_2016.csv", parse_dates=["transactiondate"])
train_df.shape
- train data가 어떻게 생겼는지 살펴보기 위해 csv 파일을 읽었습니다.
- 거래일,
transactiondate가 있는 컬럼을parse_dates를 통해 datetime type으로 형변환 했습니다.
train_df.head()
를 통해 데이터가 어떻게 생겼는지도 살펴봅니다.
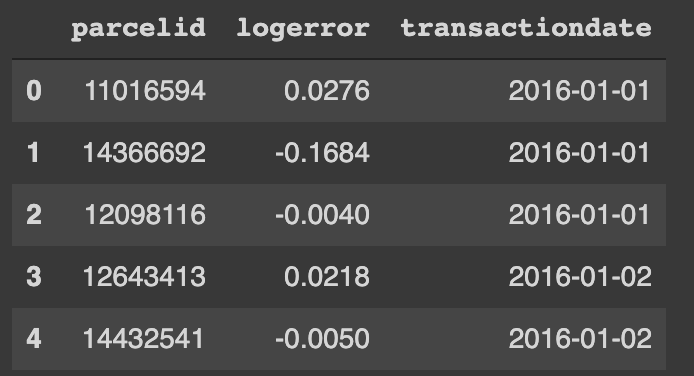
이 대회에서는 logerror를 줄이는 것이 목표입니다. 따라서 logerror와 관련된 분석을 시작하겠습니다.
plt.figure(figsize=(8,6))
plt.scatter(range(train_df.shape[0]), np.sort(train_df.logerror.values))
plt.xlabel('index', fontsize=12)
plt.ylabel('logerror', fontsize=12)

plt.show()
간단하게 logerror가 어떻게 되는 지 scatter plot을 이용해 보여주고 있습니다.
np.sort를 이용해 작은값부터 큰 값으로 정렬했습니다.- 각 행마다 logerror 값을 가져오기 위해 pandas에서 제공하는
.values를 사용했습니다. pandas 공식 문서에서는.values보다는.to_numpy를 사용하기를 추천합니다..values를 사용하는 경우에는 실제로 반환되는 값이 배열(array)인지, 배열의 어떤 변환인지, pandas의 custom 배열인 지 알 수 없다고 합니다. 더 좋은 일관성(consistency) 유지를 위해.to_numpy()의 사용을 하는 것이 좋습니다.
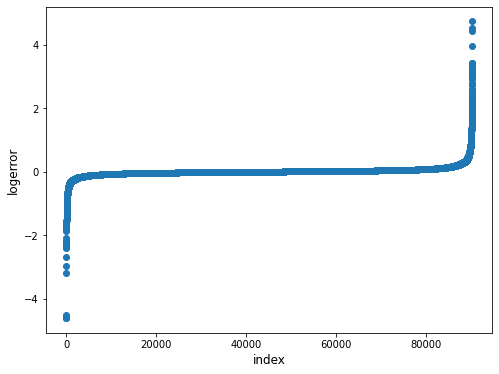
전반적으로 0에 가깝지만 가장 가장 작은값, 가장 큰 값들에 이상치(outlier)들이 많은 걸 알 수 있습니다.
이 이상치들을 지우고 히스토그램을 그려보겠습니다.
ulimit = np.percentile(train_df.logerror.values, 99)
llimit = np.percentile(train_df.logerror.values, 1)

train_df['logerror'].loc[train_df['logerror']>ulimit] = ulimit
train_df['logerror'].loc[train_df['logerror']<llimit] = llimit

plt.figure(figsize=(12,8))
sns.distplot(train_df.logerror.values, bins=50, kde=False)
plt.xlabel('logerror', fontsize=12)
plt.show()
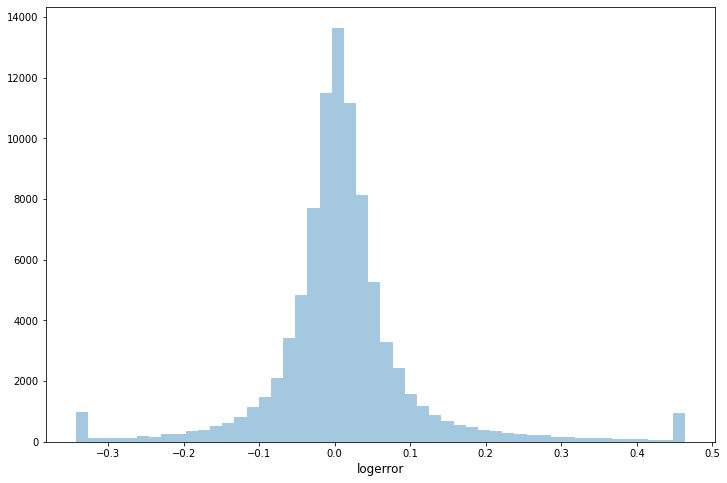
np.percentile을 이용해 가장 큰 99%, 가장 작은 1% 로ulimit,llimit을 설정하고ulimit보다 크면ulimit으로llimit보다 작으면llimit으로 값을 대체했습니다. 이 과정에서.ix명령어가 사라져.loc로 코드를 작성했습니다. 이 과정에서도copyWarning이 발생하지만 무시하기로 했으므로 그냥 넘어갑니다.- 결과가 정규분포에 가까운 모습으로 나오는 것을 볼 수 있습니다.
이제 거래일, transactiondate에 대해 분석해보겠습니다. 우선 매달마다 거래량이 어떻게 변하는 지 알아보겠습니다.
train_df['transaction_month'] = train_df['transactiondate'].dt.month

cnt_srs = train_df['transaction_month'].value_counts()
plt.figure(figsize=(12, 6))
sns.barplot(cnt_srs.index, cnt_srs.values, alpha=0.8, color=color[3])
plt.xticks(rotation='vertical')
plt.xlabel('Month of transaction', fontsize=12)
plt.ylabel('Number of Occurences', fontsize=12)
plt.show()
- 우선
'transactiondate'컬럼에서dt.month함수를 통해 무슨 달인지에 대한 정보를 가져옵니다.dt.month는 달의 정보를 1, 2, 3, … 12 와 같은 형식으로 가져옵니다. - 각 달이 나온 횟수를 뽑아내
cnt_srs에 저장합니다.
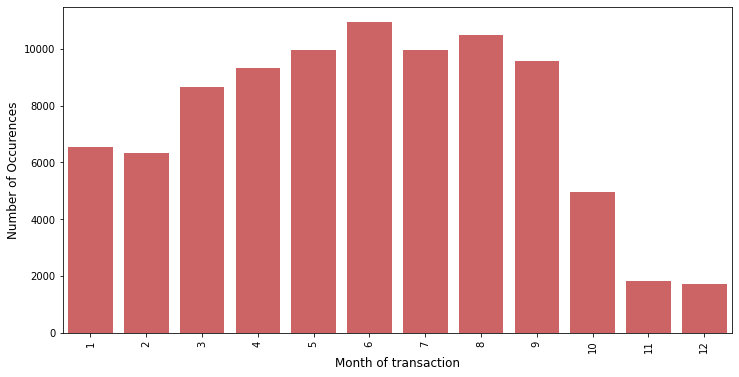
캐글의 데이터 페이지를 살펴보면 train data가 2016년 10월 15일 이전의 모든 거래내역과, 그 이후의 약간의 거래내역으로 구성되어있다고 하는 것을 보면 왜 10월에서 12월까지가 비교적 적은 거래량을 보이는 지 알 수 있습니다.
캐글의 데이터에 대한 설명을 상세히 읽어 ‘아 연말에는 부동산 거래를 잘 하지 않는구나.’ 와 같은 이상한 인사이트를 얻는 일이 없도록 해야합니다.
이제 Parcel Id, 땅에 매기는 구획번호에 대해 알아보겠습니다. 땅에 매기는 구획번호는 특정 관할권안에서 고유하다고 합니다. 그런지 한번 살펴보겠습니다.
(train_df['parcelid'].value_counts().reset_index())['parcelid'].value_counts()
복잡해보이기만 하는 위 코드는 몇개의 단계로 나눠서 쓸 수 있습니다.
train_df['parcelid'].value_counts(): 앞에서 본 것 처럼 고유한 값들을 세줍니다..reset_index(): index번호를 다시 붙여줍니다.['parcelid'].value_counts(): 2를 대상으로 다시value_counts()를 통해parcelid값을 고유한대로 세줍니다.
위 코드의 결과로, 1: 9006, 2: 123, 3: 1을 얻을 수 있습니다. 기록상의 오류인지는 조금 더 상세히 찾아봐야 알 수 있을 것 같습니다.
이제 properties_2016 파일을 뜯어보겠습니다.
prop_df = pd.read_csv('/content/properties_2016.csv.zip')
prop_df.shape
prop_df.head()
shape를 확인하고 head()로 데이터를 살짝 봤더니 NaN값이 너무 많습니다. 각 부동산 당 가지고 있는 자산이 다 달라 NaN이 많은가 싶네요.
일단 NaN값이 얼마나, 어디에, 어떻게 많은 지 살펴보겠습니다.
missing_df = prop_df.isnull().sum(axis=0).reset_index()
missing_df.columns = ['column_name', 'missing_count']
missing_df = missing_df.loc[missing_df['missing_count']>0]
missing_df = missing_df.sort_values(by='missing_count')

idx = np.arange(missing_df.shape[0])
width = 0.9
fig, ax = plt.subplots(figsize=(12, 18))
rects = ax.barh(idx, missing_df.missing_count.values, color='blue')
ax.set_yticks(idx)
ax.set_yticklabels(missing_df.column_name.values, rotation='horizontal')
ax.set_xlabel("Count of missing values")
ax.set_title("Number of missing values in each column")
plt.show()
코드부터 하나하나 살펴보겠습니다.
missing_df = prob_df.isnull().sum(axis=0).reset_index():prob_df에서 결측값, missing values를 찾기위해.isnull()을 했습니다. 그 뒤에(axis=0)으로, 즉 내려가면서 합을 구합니다. 이 때True는 1 False는 0 이 됩니다. 그 뒤reset_index()를 통해 index를 다시 붙여줍니다. (axis=0)은 가로축을 의미합니다. 가로축 방향으로 길게 뻗은 막대기가 아래로 내려간다고 생각하면 어떤 방향 연산인지 떠올리기가 쉽습니다.missing_df.columns = ['column_name', 'missing_count']을 통해 column의 이름을 붙여줍니다.missing_df = missing_df.loc[missing_df['missing_count']>0]:missing_count가 0보다 큰 데이터프레임을 뽑아서 새로 데이터프레임을 지정해줍니다.missing_df = missing_df.sort_values(by='missing_count'):missing_count를 기준으로 정렬해줍니다.- 그래프는
missing_df의 길이만큼 인덱스를 만들어주고,missing_df의missing_count.values들을 하나씩 세우는 막대그래프를 그렸습니다.
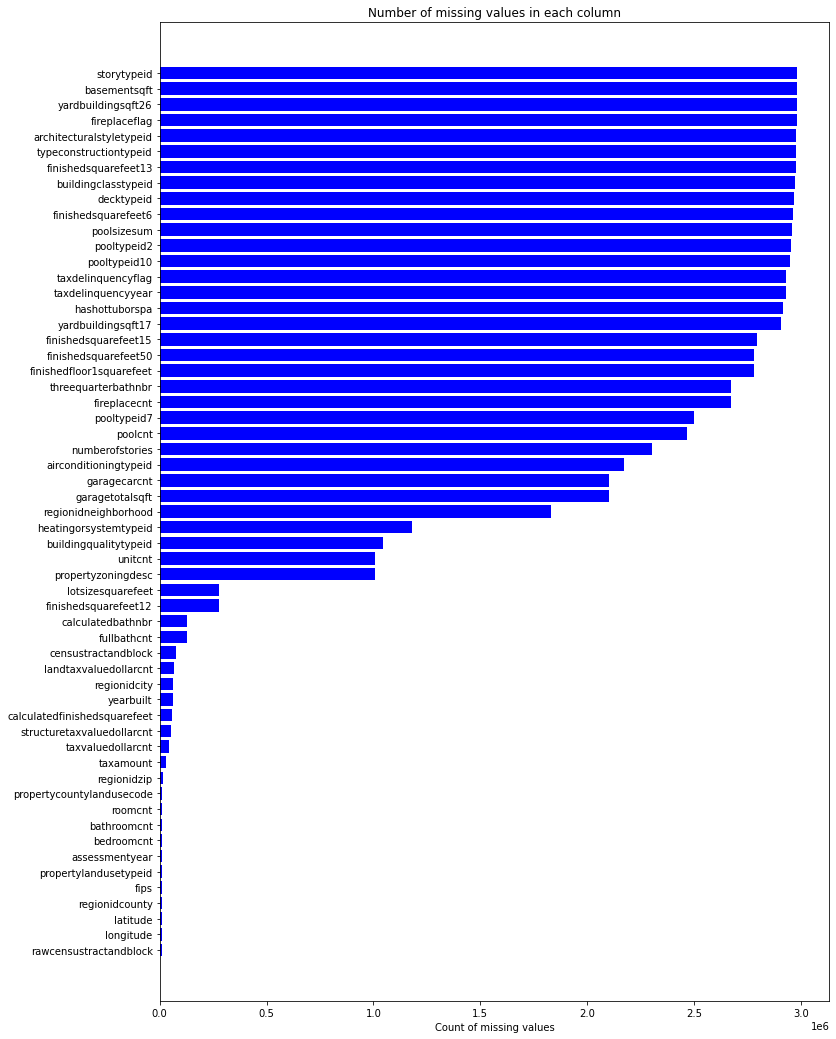
이제 부동산 데이터가 어떤 위치에 많이 놓여있는 지에 대해 알아보기 위해 (위도, 경도)를 시각화해보겠습니다.
plt.figure(figsize=(12, 12))
sns.jointplot(x=prop_df.latitude.values, y=prop_df.longitude.values, height=10)
plt.ylabel('Longitude', fontsize=12)
plt.xlabel('Latitude', fontsize=12)
plt.show()
다른 특별한 건 없고 Seaborn의 jointplot은 두 변수에 대해 이변량, 일변량 그래프를 그리는 함수입니다.
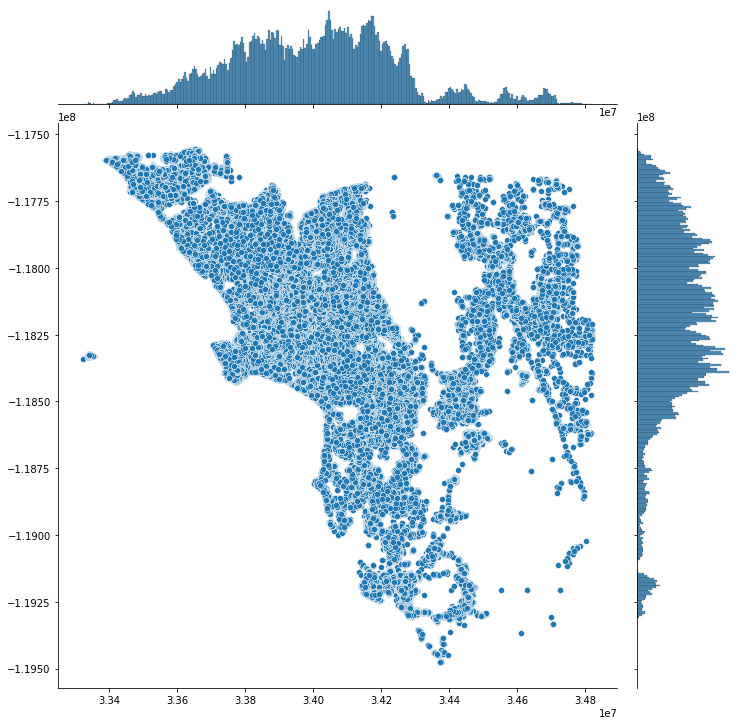
따라서 위도, 경도에 따라 어디에 분포되어있는지 이변량 함수가 가운데에 그려져 있고, 각각의 분포는 어떠한가에 대해 x축, y축의 끝에 그려져있습니다.
Kaggle 대회 내의 data 페이지를 살펴보면 이 데이터는 Los Angeles, Orange and Ventura, California 세 구역에 대한 2016년 전체 부동산 데이터를 가지고 있습니다.
train 데이터에는 90275개의 행이 있고 properties 파일에는 2,985,217 개의 행이 있습니다. 이제 이 두 파일을 합쳐서 분석을 해보겠습니다.
train_df = pd.merge(train_df, prop_df, on='parcelid', how='left')
train_df.head()
코드를 보게 되면, train_df의 왼쪽에 prop_df를 parcelid를 기준으로 합치고 있는 것을 볼 수 있습니다.
분석의 편의를 위해 각 변수의 자료형에 대해 살펴보겠습니다.
대부분의 변수는 실수형(float)이며, object 변수는 거의 없습니다. 자세히 갯수를 세보겠습니다.
dtype_df.groupby("Column Type").aggregate('count').reset_index()
groupby함수는 mapper나 Series of columns를 이용해 데이터프레임을 묶어주는 역할을 합니다. 즉groupby()안의 parameter를 기준으로 묶는 것으로, 그 parameter가 일종의 새로운 index, 행으로 옮겨간다고 생각할 수 있습니다.aggregate는 한개 이상의 operation을 특정 축에 시행하는 함수입니다.
이제 합쳐진 새로운 데이터에서 결측치, Null의 갯수를 세보겠습니다.
missing_df = train_df.isnull().sum(axis=0).reset_index()
missing_df.columns = ['column_name', 'missing_count']
missing_df['missing_ratio'] = missing_df['missing_count'] / train_df.shape[0]
missing_df.loc[missing_df['missing_ratio']>0.999]
위에서 결측치를 체크했을 때와 똑같은 방식의 코드입니다. 다만 마지막에 missing_ratio가 99.9%가 넘는 데이터를 뽑아내는 코드를 추가했습니다.
변수가 너무 많기 때문에, 실수형, float 변수만 살펴보면서 목표로 하는 target variable과 어떤 관련이 있나 살펴보겠습니다.
mean_values = train_df.mean(axis=0)
train_df_new = train_df.fillna(mean_values)

x_cols = [col for col in train_df_new.columns if col not in ['logerror'] if train_df_new[col].dtype=='float64']
labels = []
values = []
for col in x_cols:
    labels.append(col)
    values.append(np.corrcoef(train_df_new[col].values, train_df_new.logerror.values)[0,1])
corr_df = pd.DataFrame({'col_labels':labels, 'corr_values':values})
corr_df = corr_df.sort_values(by='corr_values')

idx = np.arange(len(labels))
width = 0.9
fig, ax = plt.subplots(figsize=(12,40))
rects = ax.barh(idx, np.array(corr_df.corr_values.values), color='y')
ax.set_yticks(idx)
ax.set_yticklabels(corr_df.col_labels.values, rotation='horizontal')
ax.set_xlabel('Correlation coefficient')
ax.set_title('Correlation coefficient of the variables')

plt.show()
- 상관관계를 알아보기 위해 우선 결측치를 모두 평균값으로 채운 새로운 데이터프레임을 생성했습니다.
- 그리고 list comprehension을 통해
train_df_new의 column들 중에['logerror']를 제외하고 모든 실수형의 column을 가져왔습니다. if문 2개로 작성한 구문을 and로 바꿔주는 편이 좋아보입니다. x_cols를 반복하면서,col은labels에np.corrcoef(~)는values에 추가했습니다.np.corrcoef는 Pearson 상관계수를 반환하는 함수로, covariance matrix의 normalized 된 모습으로 볼 수 있습니다. 식은 아래와 같습니다.
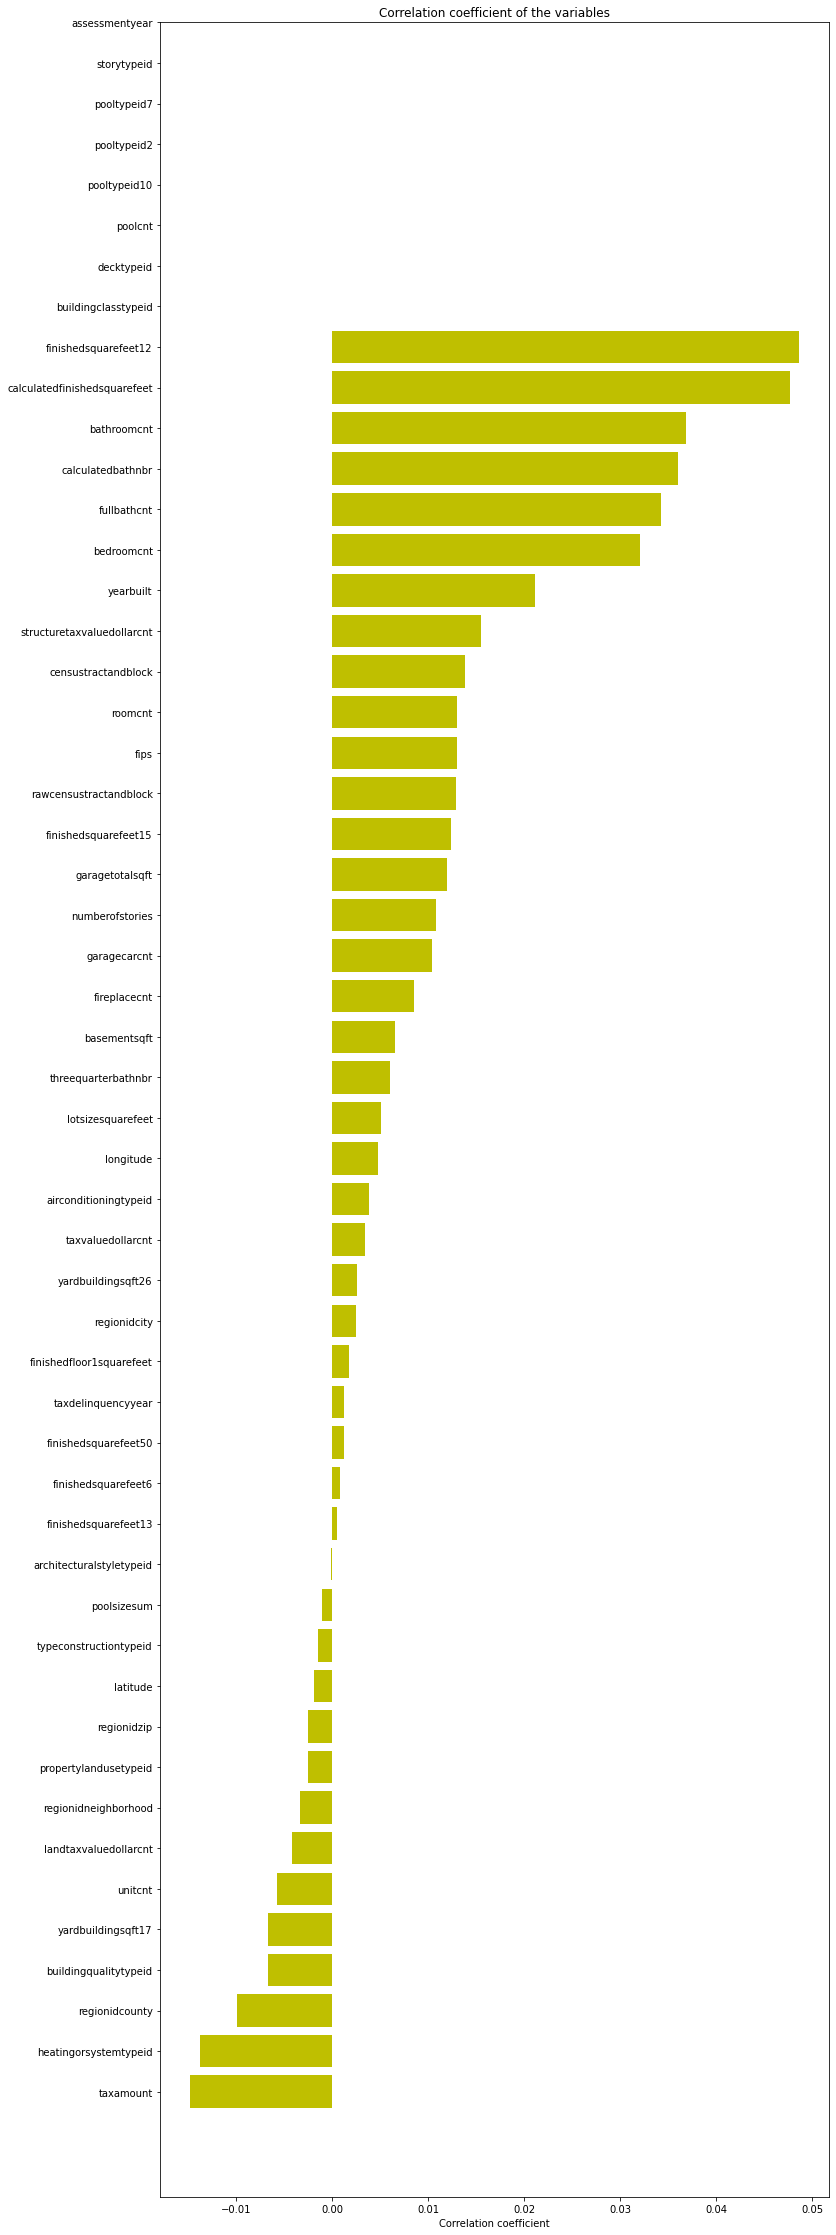
Person 상관계수는 $[-1, 1]$에 놓입니다. 절댓값이 클수록 상관관계가 크며, 부호는 그 방향성을 나타냅니다. 따라서 -1에 가까울수록 음의 상관관계가 크고, 1에 가까울수록 양의 상관관계가 큽니다.
위 그래프를 통해보면 대부분 상관관계가 전반적으로 매우 맞다는 것을 볼 수 있습니다. 가장 위에는 상관계수가 0인 변수들도 있는데, 아마 유일한 값을 가져 그럴 것이라 추정하고 그 추정이 맞는 지 확인해보겠습니다.
corr_zero_cols = ['assessmentyear', 'storytypeid', 'pooltypeid2', 'pooltypeid7', 'pooltypeid10', 'poolcnt', 'decktypeid', 'buildingclasstypeid']
for col in corr_zero_cols:
    print(col, len(train_df_new[col].unique()))
assessmentyear 1
storytypeid 1
pooltypeid2 1
pooltypeid7 1
pooltypeid10 1
poolcnt 1
decktypeid 1
buildingclasstypeid 1
확인결과 전부 하나의 값을 가지는 것을 확인할 수 있었습니다.
이번엔 상관관계가 높은 변수를 대상으로 분석을 해보겠습니다.
corr_df_sel = corr_df.loc[(corr_df['corr_values']>0.02) | (corr_df['corr_values'] < -0.01)]
corr_df_sel
cols_to_use = corr_df_sel.col_labels.tolist()

temp_df = train_df[cols_to_use]
corrmat = temp_df.corr(method='spearman')
f, ax = plt.subplots(figsize=(8,8))

sns.heatmap(corrmat, vmax=1., square=True)
plt.title("Importatn variables correlation map", fontsize=15)
plt.show()
corr_df_sel ~ temp_df: 상관관계가 높은 변수들을 데이터프레임으로 만들고, 그 컬럼들을 가져와 원래 데이터에서 사용하겠습니다.temp_df.corr(method='spearman'): 상관관계를 스피어먼 상관 계수, Spearman rank correlation coefficient를 이용해 구하곘습니다. 스피어먼 계수란 두 변수간의 랭크가 얼마나 상관있는지 보는 계수입니다. 두 변수가 얼마나 단조함수, monotonic function으로 나타낼 수 있는 지 체크할 수 있습니다. 그에 따라 부호는 방향을 의미하고, 일반적으로 커질수록 두 변수가 단조함수로 잘 표현된다고 생각할 수 있습니다.- 이를 heatmap을 이용하여 그래프를 그렸습니다.
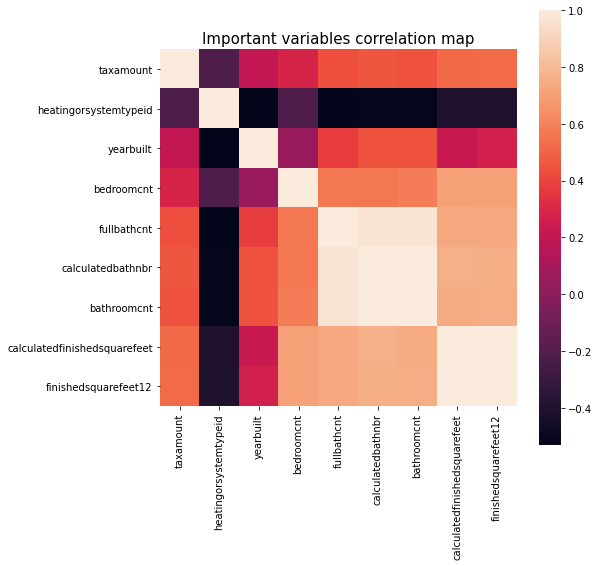
스피어먼 상관계수 정의에 따르면 대각선 방향의 값들이 모두 1인 걸 알 수 있습니다. 이제 각각의 변수들을 한번 살펴보겠습니다.(그런 의미 아닐까?)
일반적으로 다른 변수들과 큰 상관관계를 가지는 finished square feet 12가 log error에 따라 어떻게 변하는 지 알아보겠습니다. finished square footage에 포함이 되는 공간은 벽, 바닥, 천장, 열원(가스레인지) 등으로 일반적으로 도면에서의 넓이라고 볼 수 있을 것 같습니다.
col = "finishedsquarefeet12"
ulimit = np.percentile(train_df[col].values, 99.5)
llimit = np.percentile(train_df[col].values, 0.5)
train_df[col].loc[train_df[col]>ulimit] = ulimit
train_df[col].loc[train_df[col]<llimit] = llimit

plt.figure(figsize=(12,12))
sns.jointplot(x=train_df.finishedsquarefeet12.values, y=train_df.logerror.values, height=10,
              color=color[4])
plt.ylabel('Log error', fontsize=12)
plt.xlabel('Finished Square Feet 12', fontsize=12)
plt.title('Finsished square feet 12 vs Log error', fontsize=12)
plt.show()
np.percentile을 이용해 데이터를 수정해주고finshedsquarefeet12.values를 x축으로logerror.values를 y축으로 하는jointplot을 그렸습니다.
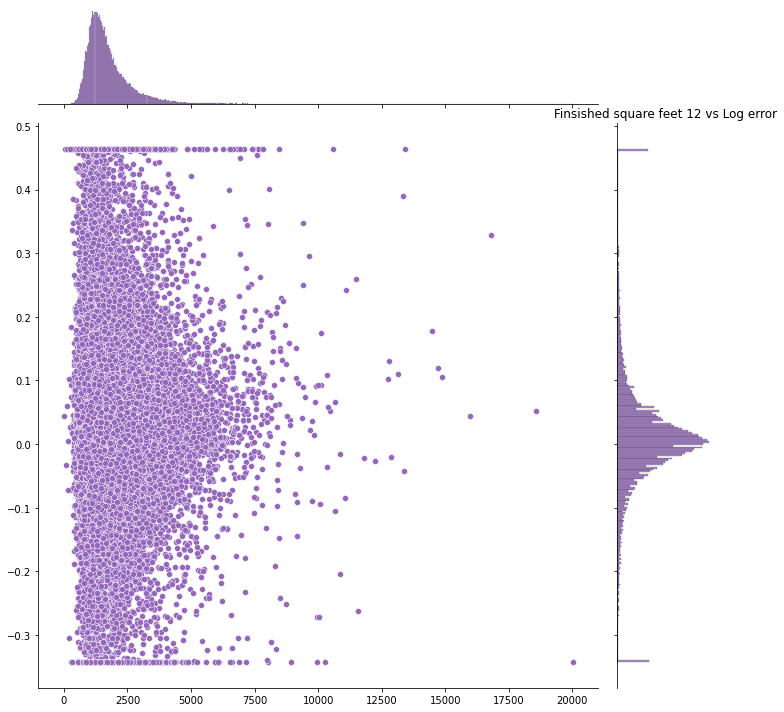
이상치가 존재하는 것을 제외하면 logerror의 분포가 finished square feet 12 변수가 커질수록 좁아지고 있습니다. 어쩌면 큰 집들이 조금 더 추정하기 쉽다는 것을 말하는 것인지 알아보겠습니다.
calculated finished square feet에 대해서도 위와 같이 분석을 해보겠습니다.
col = "calculatedfinishedsquarefeet"
ulimit = np.percentile(train_df[col].values, 99.5)
llimit = np.percentile(train_df[col].values, 0.5)
train_df[col].loc[train_df[col]>ulimit] = ulimit
train_df[col].loc[train_df[col]<llimit] = llimit

plt.figure(figsize=(12,12))
sns.jointplot(x=train_df.calculatedfinishedsquarefeet.values, y=train_df.logerror.values, height=10,
              color=color[5])
plt.ylabel('Log error', fontsize=12)
plt.xlabel('Calculated finished square feet', fontsize=12)
plt.title('Calculated finished square feet vs Log error', fontsize=12)
plt.show()
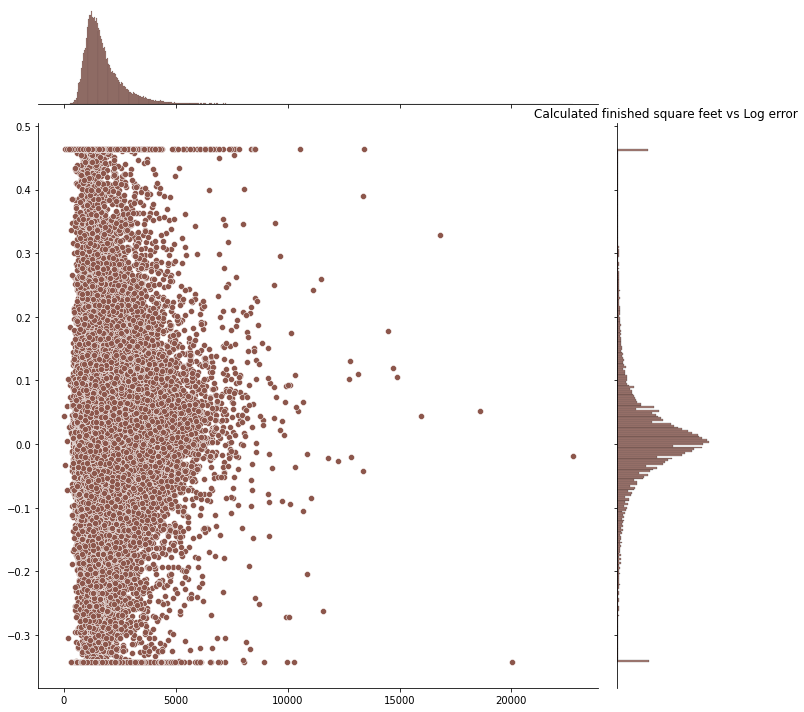
둘은 거의 비슷한 그래프를 보이며, 이는 둘의 상관계수가 매우 높다는 점과도 일맥상통 하는 이야기 입니다.
이번엔 욕실의 수를 간단하게 알아보겠습니다.
plt.figure(figsize=(12, 8))
sns.countplot(x='bathroomcnt', data=train_df)
plt.ylabel('Count', fontsize=12)
plt.xlabel('Bathroom', fontsize=12)
plt.xticks(rotation='vertical')
plt.title("Frequency of Bathroom count", fontsize=15)
plt.show()
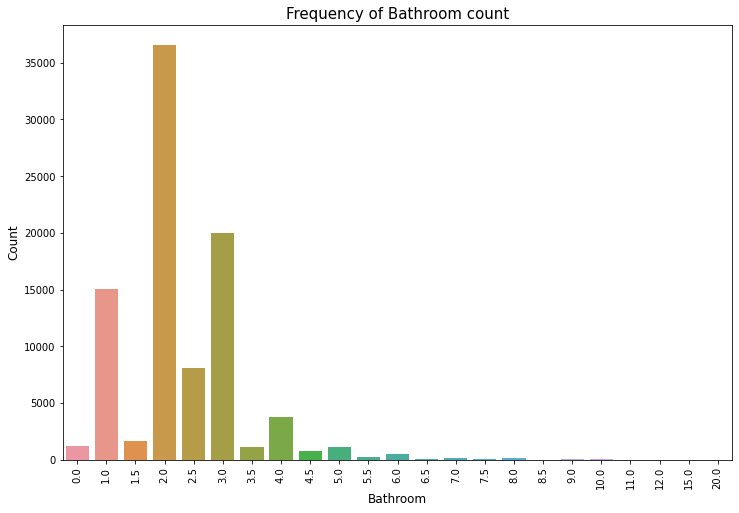
필사를 하는 원본에는 2.279… 로 나타나는 숫자가 있는데 평균값이라고 합니다. 어쨌든 이 그래프에서도 0.5 단위로 표가 나오는데 2.5개의 욕실을 의미하는 것인지, 평균인지는 따로 살펴봐야겠습니다.
log error의 욕실의 수에 따른 변화에 대해서 알아보겠습니다.
plt.figure(figsize=(12,8))
sns.boxplot(x='bathroomcnt', y='logerror', data=train_df)
plt.ylabel('Log error', fontsize=12)
plt.xlabel('Bathroom Count', fontsize=12)
plt.xticks(rotation='vertical')
plt.title('How log error changes with bathroom count?', fontsize=15)
plt.show()
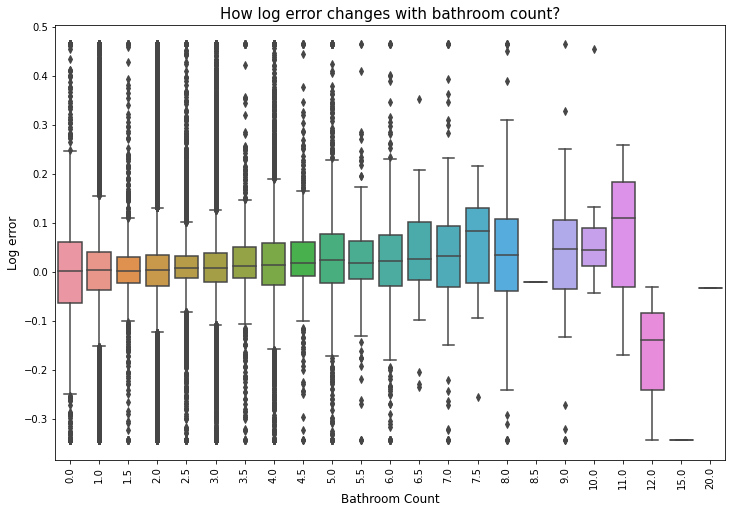
그래프에서 볼 수 있듯이, 대부분의 분포가 log error가 0 근방에 있다가 Bathroom count가 7.5, 11.0, 12.0 인 경우에는 log error가 넓게 분포하고 median값이 0에서 조금씩 벗어나고 있는 것을 볼 수 있습니다.
(Null value를 replace하고 나서 3.03이라는 평균을 얻었다는 부분은 데이터를 업데이트 하면서 NaN value가 모두 사라진 것 같습니다.)
분포가 흔들리기 시작하는 7을 넘는 값들을 7로 치환해주고 분포를 살펴보겠습니다.
train_df['bedroomcnt'].loc[train_df['bedroomcnt']>7]=7
plt.figure(figsize=(12,8))
sns.violinplot(x='bedroomcnt', y='logerror', data=train_df)
plt.xlabel('Bedroom count', fontsize=12)
plt.ylabel('Log error', fontsize=12)
plt.show()
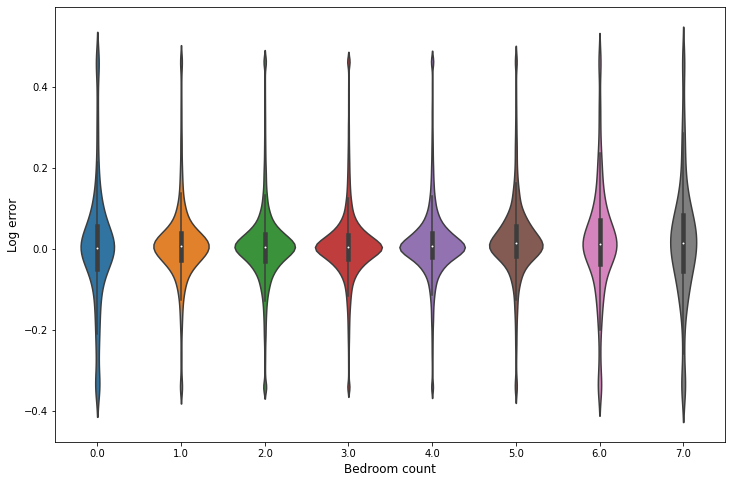
7 초과의 값들을 없애주고 나니 훨씬 균일한 분포를 보이긴 하지만 아직도 끝으로 갈수록 조금씩 퍼지는 모양을 확인할 수 있습니다.
이번에는 세금과 logerror 사이의 관계를 살펴보겠습니다.
col = 'taxamount'
ulimit = np.percentile(train_df[col].values, 99.5)
llimit = np.percentile(train_df[col].values, 0.5)
train_df[col].loc[train_df[col]>ulimit] = ulimit
train_df[col].loc[train_df[col]<llimit] = llimit

plt.figure(figsize=(12,12))
sns.jointplot(x=train_df[col].values, y=train_df['logerror'].values, height=10, color='g')
plt.ylabel('Log error', fontsize=12)
plt.xlabel('Tax amount', fontsize=12)
plt.title('Tax amount vs Log error', fontsize=15)
plt.show()
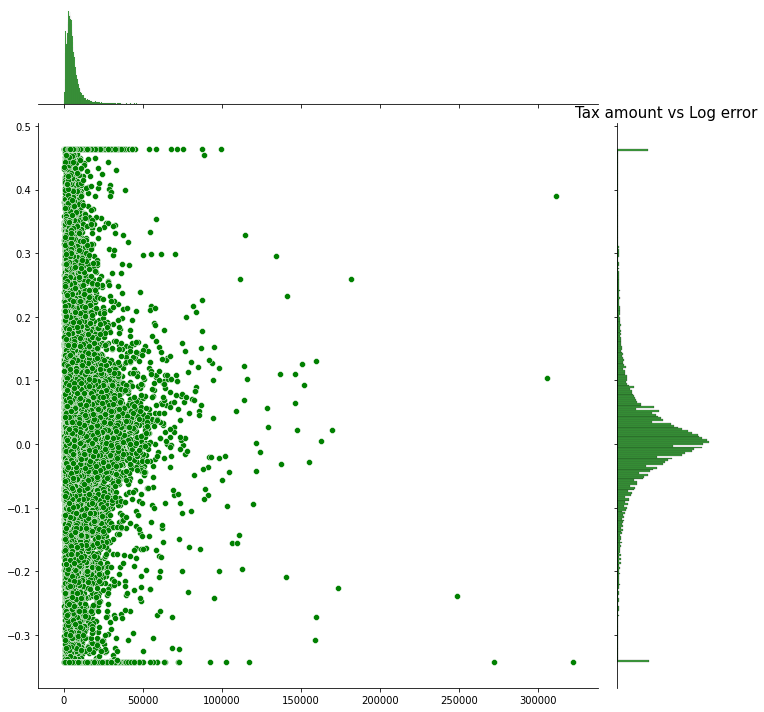
이 그림 또한 대부분의 데이터가 logerror가 0인 지점 근처에 몰려있는 정규분포와 비슷한 모습을 하고 있습니다.
이번엔 지어진 년도, yearbuilt와 logerror 사이의 관계를 알아보겠습니다.
from plotnine import *
ggplot(aes(x='yearbuilt', y='logerror'), data=train_df) + \
    geom_point(color='steelblue', size=1) + \
    stat_smooth()
ggplot을 그려야하는데 기존의 코드처럼 ggplot 모듈을 설치하면 오류가 많이 납니다. 예전 모듈이다 보니 Pandas 내부에서 사라진 방법들이 많아 잘 돌아가지 않았습니다. 별도로 코드를 수정해가며 사용해보려고 했지만, 잘 되지 않아 ggplot 깃헙에서 PR을 읽던 중에 plotnine을 알게되어 사용하게 됐습니다.
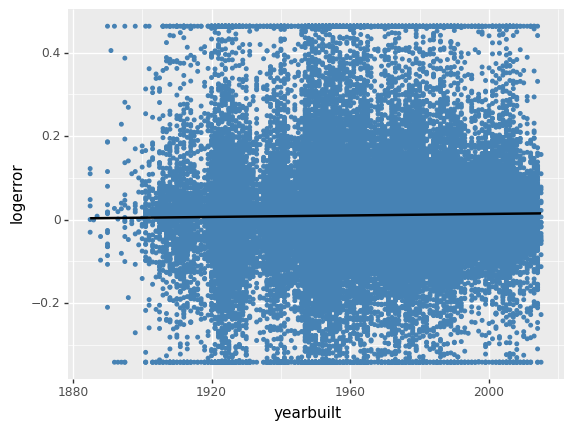
그래프를 살펴보면 아주 작은 기울기의 선형성을 조금 보이고 있습니다.
계속 ggplot을 이용해, 경도/위도, longitude, latitude 와 logerror 사이의 관계를 살펴보겠습니다.
ggplot(aes(x='latitude', y='longitude', color='logerror'), data=train_df) + \
    geom_point() + \
    scale_color_gradient(low='red', high='blue')
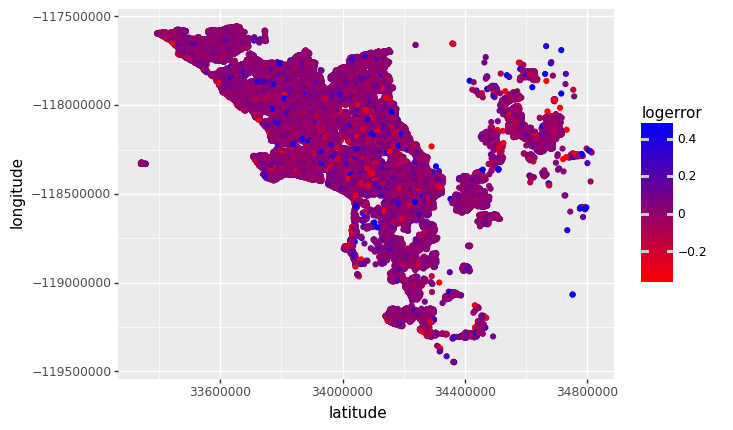
위 그래프르 봤을 때는 딱히 시각적으로 눈여겨볼 만한 점이 보이지 않습니다. 따라서 가장 큰 양의 상관관계와 가장 큰 음의 상관관계를 보이는 변수들을 살펴보겠습니다.
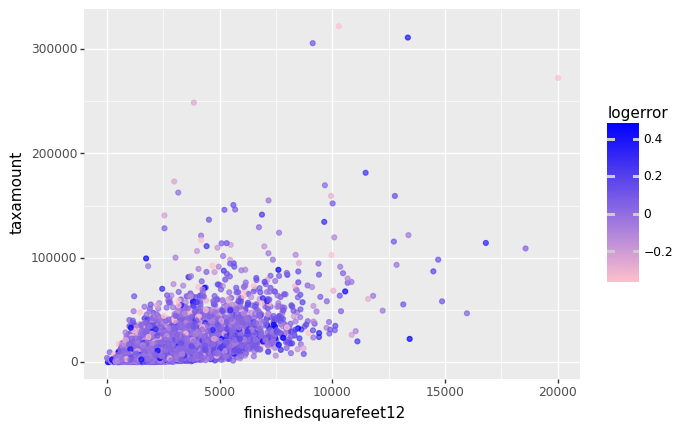
이 또한 딱히 유의미한 점은 보이지 않습니다.
단변량분석(univariate analysis)를 통해 중요한 변수가 있다는 것을 알아냈습니다. 하지만 이러한 분석은 하나만 바라보는 데에 기반을(stand alone basis) 두고 있고 또한 선형성을 가정하고 있습니다.
다음으로는 Extra Trees model을 통해 비선형성 모델을 만들어 중요한 변수들을 얻어보겠습니다.
train_y = train_df['logerror'].values
cat_cols = ["hashottuborspa", "propertycountylandusecode", "propertyzoningdesc", "fireplaceflag", "taxdelinquencyflag"]
drop_train_df = train_df.drop(['parcelid', 'logerror', 'transactiondate', 'transaction_month'] + cat_cols, axis=1)
feat_names = train_df.columns.values
train_y에 logerror 값들을 넣어줍니다.- category 변수는 트리모델분석시 사용이 불가능하므로
cat_cols로 모으고, 기타 날짜형 변수등도drop해줍니다. - 이제 남은 수치형 변수 컬럼들을
feat_names에 모아줍니다.
drop_train_df = drop_train_df.fillna(0)
from sklearn import ensemble
model = ensemble.ExtraTreesRegressor(n_estimators=25, max_depth=30, max_features=0.3, n_jobs=-1, random_state=0)
model.fit(drop_train_df, train_y)
-
트리 모델 생성시 NaN value가 있어서 불가능하다는 오류가 떠서
fillna(0)을 했습니다.ExtraTreesRegressor 클래스는 meta 추정기를 만드는데, 그 추정기는 많은 랜덤 결정 트리를 데이터셋의 다양한 샘플에 fit하고 정확도를 올리고 overfitting을 컨트롤하기 위해 평균화(averaging)를 사용합니다. 엑스트라 트리는 기존의 랜덤포레스트 모델에서 무작위로 특성을 분할해 더욱 무작위하게 만드는 모델입니다.
아직 머신러닝에 대한 지식이 부족해 추후에 더 정리해보도록 하겠습니다.
-
Output으로는 다음과 같은 Regressor가 나옵니다.
ExtraTreesRegressor(bootstrap=False, ccp_alpha=0.0, criterion=’mse’, max_depth=30, max_features=0.3, max_leaf_nodes=None, max_samples=None, min_impurity_decrease=0.0, min_impurity_split=None, min_samples_leaf=1, min_samples_split=2, min_weight_fraction_leaf=0.0, n_estimators=25, n_jobs=-1, oob_score=False, random_state=0, verbose=0, warm_start=False)
importances = model.feature_importances_
std = np.std([tree.feature_importances_ for tree in model.estimators_], axis=0)
indices = np.argsort(importances)[::-1][:20]

plt.figure(figsize=(12,12))
plt.title('Feaute importances')
plt.bar(range(len(indices)), importances[indices], color='tomato', yerr=std[indices], align='center')
plt.xticks(range(len(indices)), feat_names[indices], rotation='vertical')
plt.xlim([-1, len(indices)])
plt.show()
.feature_importances_를 통해 특성의 중요성을 가져오고 이 특성들의 표준편차도 위와 같이 구합니다. 그리고중요도가 높은 상위 20개의 특성을 indices에 넣습니다.
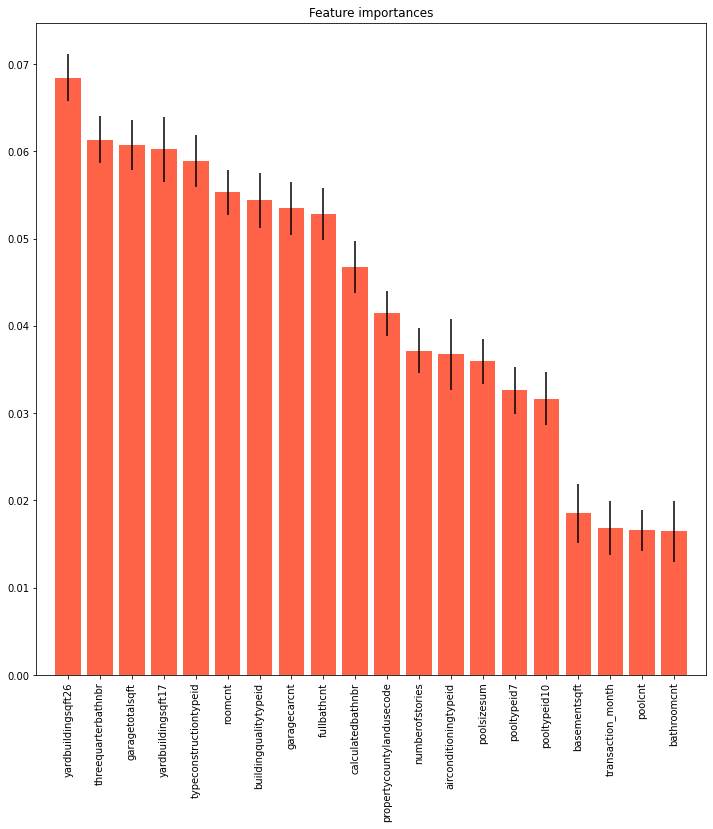
그래프의 결과로 봤을때는 ‘yardbuildingsqft26’ 변수가 가장 중요한 변수로 보입니다.
XGBoost를 사용해서 중요도를 분석해보겠습니다. XGBoost는 Extreme Gradient Boosting의 약자로, Gradient Boost 기법을 병렬 학습이 지원되도록 발전시킨 형태라고 합니다.
(이 부분도 머신러닝을 공부하며 내용을 추가하겠습니다.)
import xgboost as xgb
xgb_parmas = {
    'eta': 0.05,
    'max_depth': 8,
    'sub_sample': 0.7,
    'colsample_bytree': 0.7,
    'objective': 'reg:linear',
    'silent': 1,
    'seed': 0
}
dtrain = xgb.DMatrix(drop_train_df, train_y, feature_names=drop_train_df.columns.values)
model = xgb.train(dict(xgb_parmas, silent=0), dtrain, num_boost_round=50)

fig, ax = plt.subplots(figsize=(12,18))
xgb.plot_importance(model, max_num_features=50, height=0.8, ax=ax)
plt.show()
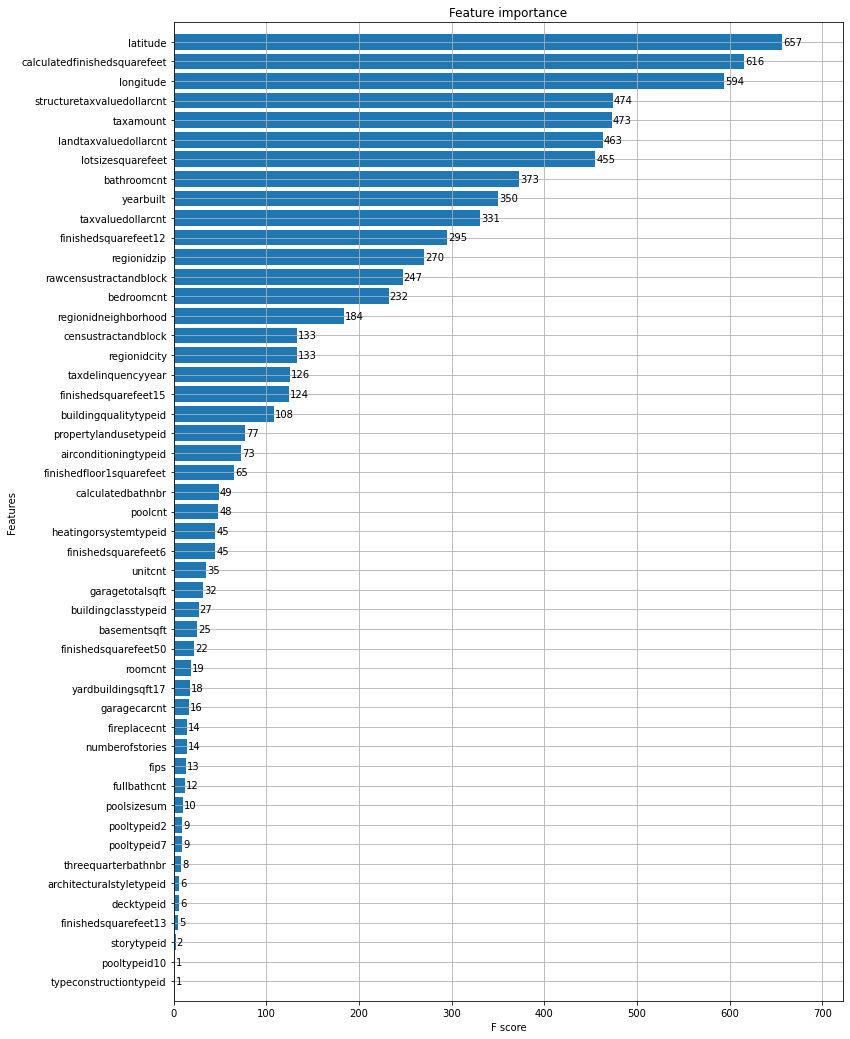
XGBoost로 그린 그래프에서는 ‘latitude’ 가 가장 중요성이 높은 변수로 볼 수 있습니다.
Conclusion
다양한 모듈로 다양한 그림을 통해 분석을 할 수 있다는 사실을 알 수 있었습니다. 필사를 하면서 ‘이렇게 할 수 있구나.’ 하며 최대한 알아가려고 노력했습니다. 특히 jointplot을 그려서 다양한 그래프를 한번에 보여주면서 효과적으로 보여줬던 점, heatmap을 효과적으로 썼던 점이 놀라웟습니다.
TODO
- 고치고 싶은 부분 수정하기: pandas setting copy warning 관련 부분.
values를to.numpy()로 수정하기.- matplotlib, seaborn 등등 객체지향으로 바꾸기.
Leave a comment